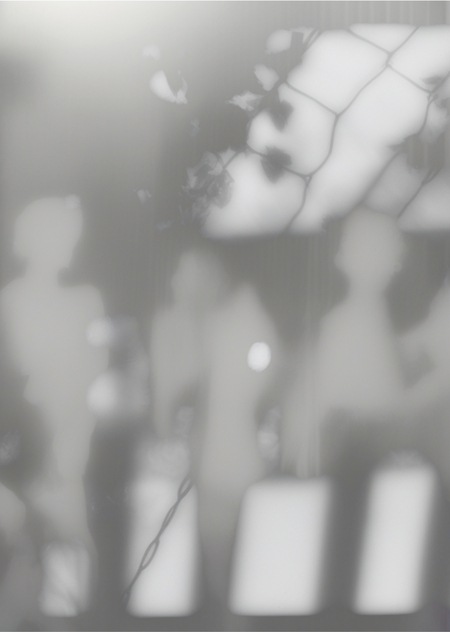
✶ идея
В основе проекта — серия моих фотографий, переведенных в негатив, в единой обработке: блюр, монохромная палитра, размытые контуры и интенсивное свечение светлых участков.Мне было интересно исследовать, способна ли нейросеть распознать и воспроизвести эти особенности как единый визуальный язык и стиль.В качестве цели — обучить модель на собственных фотографиях и создать новую серию изображений, сохранив узнаваемую эстетику исходного материала.
✶ исходные изображения
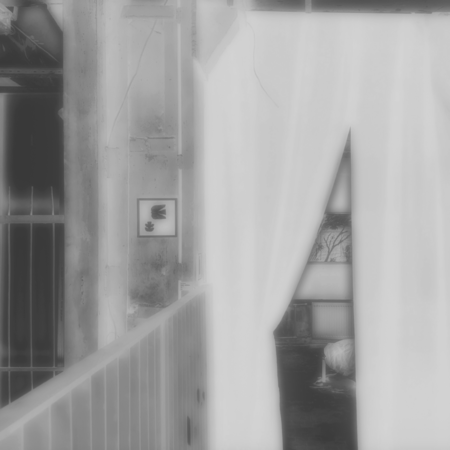
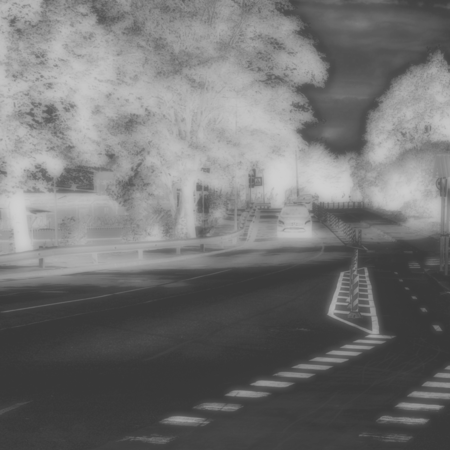
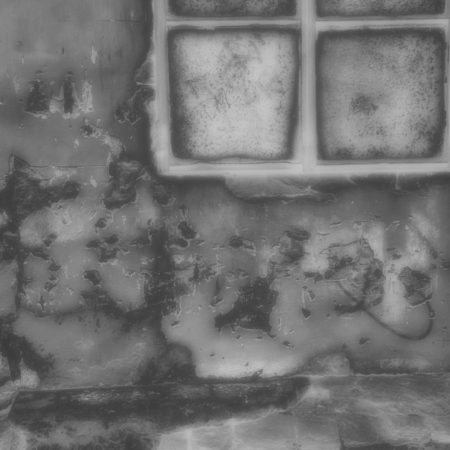
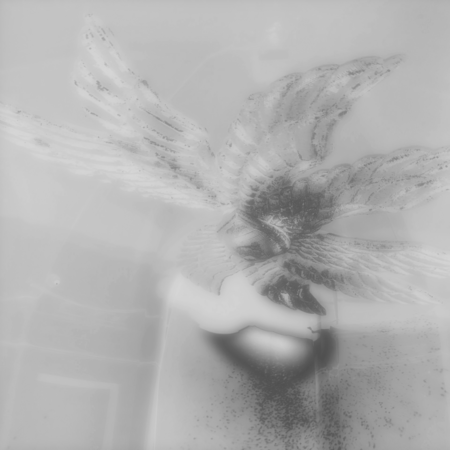
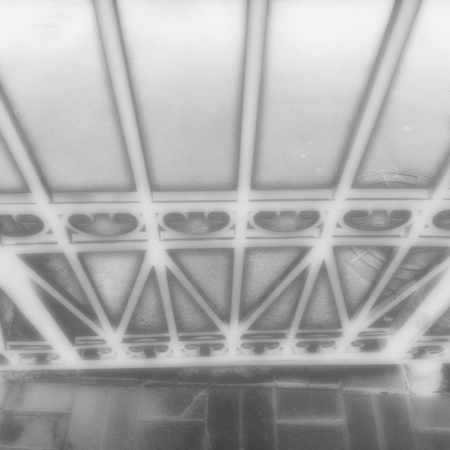
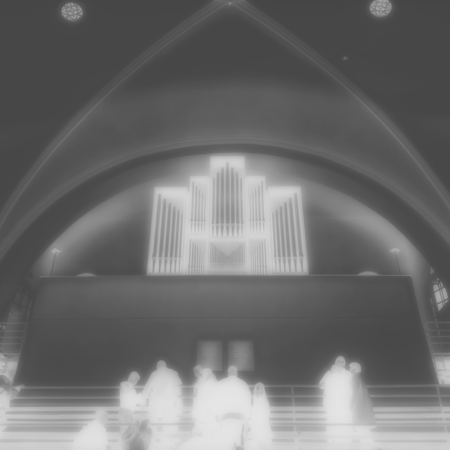
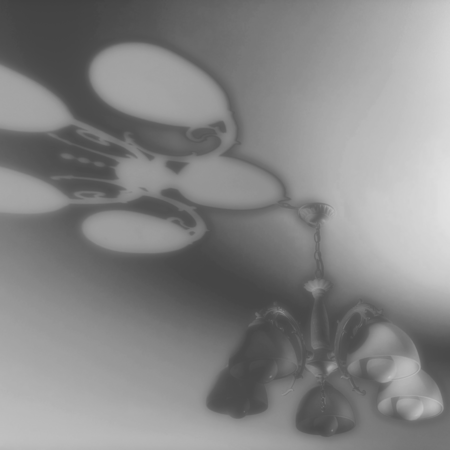
Для обучения был собран датасет из 50 авторских фотографий. В подборку вошли архитектурные фрагменты, городские пространства, предметы и природные сюжеты. Некоторые детали почти исчезают в светлых участках, а другие становятся заметнее за счёт тёмных пятен и текстур.
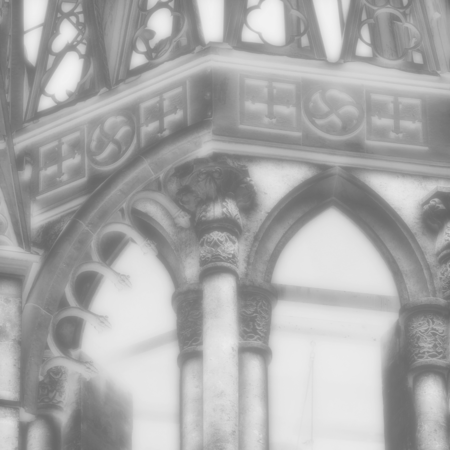
✶ обучение модели
— Для проекта использовалась генеративная модель Stable Diffusion XL 1.0.
— Адаптация модели проводилась с помощью DreamBooth LoRA. Метод позволяет обучить дополнительные параметры модели на небольшой подборке изображений, не переобучая всю базовую нейросеть.
— Каждая фотография получила текстовую подпись с помощью модели BLIP, после чего к описаниям были добавлены характеристики нужного стиля.
— Для обозначения обучаемой эстетики использовался идентификатор siaxmono. Он стал частью текстовых запросов как при обучении и при последующей генерации.Для итоговой серии использовалась генерация новых изображений по текстовым запросам (Text-to-Image).
Базовая модель: Stable Diffusion XL 1.0
Метод: DreamBooth LoRA
Обучающий датасет: 50 фотографий
Разрешение: 768 × 768 пикселей
Конфигурация обучения: 500 шагов
LoRA rank: 16
Learning rate: 0.0001
Среда: Google Colab, NVIDIA T4
✶ результирующая серия изображений
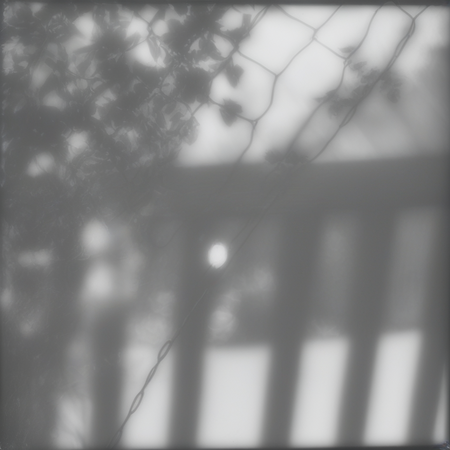
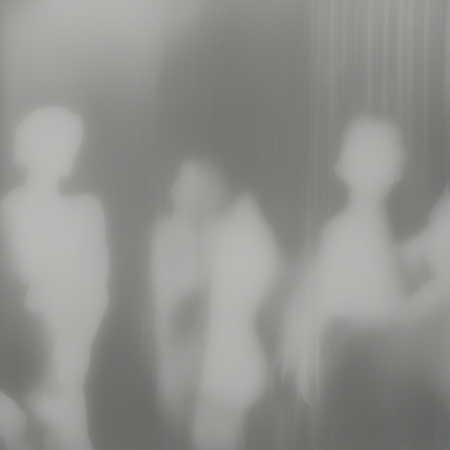
01_fence / 02_afterimages
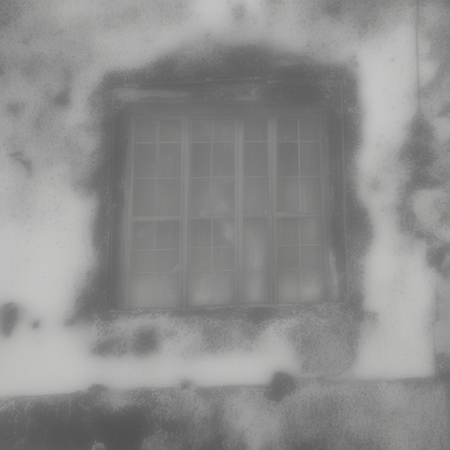
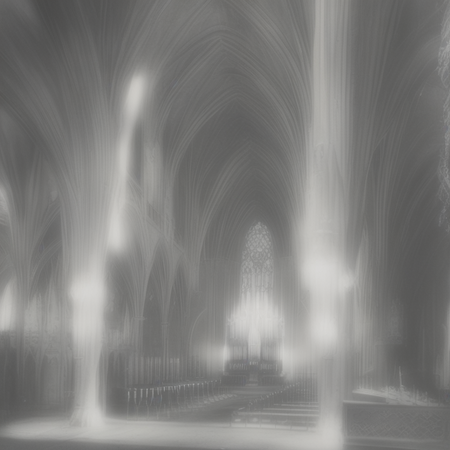
03_window / 04_cathedral
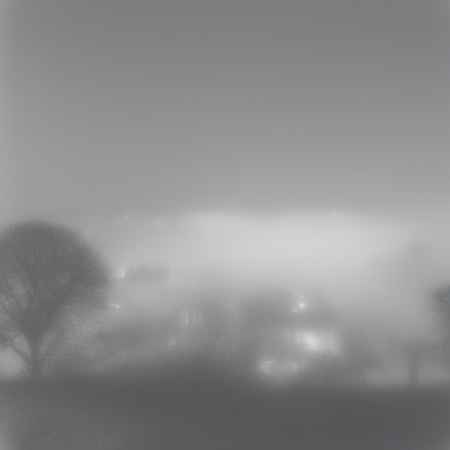
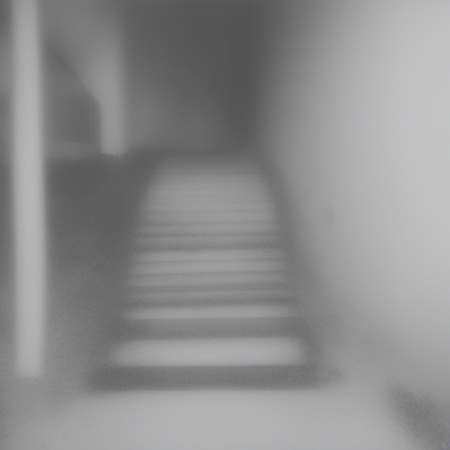
05_landscape / 05_threshold
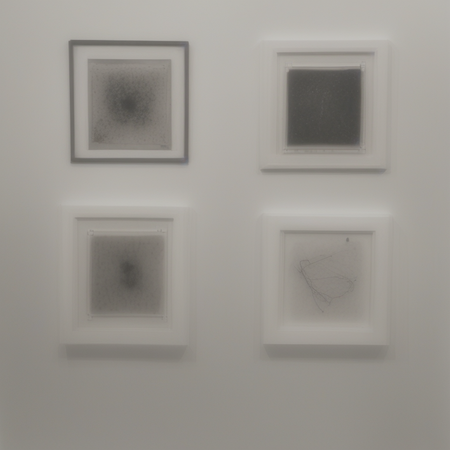
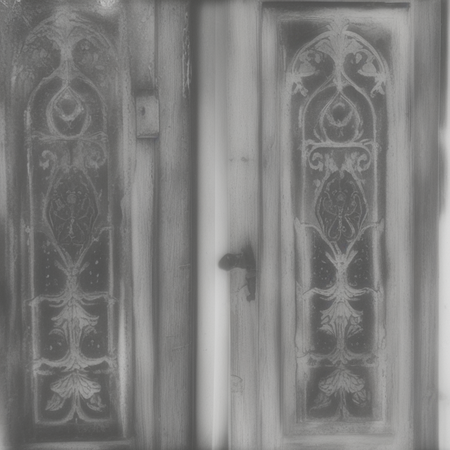
07_artworks / 08_door
✶ анализ результатов
В результате обучения и генерации удалось получить серию с достаточно последовательной визуальной эстетикой. Наиболее заметно передаются монохромность и тональность, засвеченные участки тоже хорошо выделяются, особенно в архитектурных сюжетах, где свечение взаимодействует с геометрией пространства.При этом модель неодинаково интерпретирует различные объекты. В изображениях с архитектурой сохраняется больше структурных деталей и линий. А вот человеческие фигуры становятся почти беспредметными световыми силуэтами. Природный пейзаж приобретает более мягкую фактуру. По сравнению с исходными фотографиями генерации выглядят более сглаженными. Некоторые мелкие детали воспроизводятся менее точно.В процессе работы я корректировала текстовые запросы, регулируя выраженность свечения, детализацию и характер композиции. Для отдельных изображений потребовалось усилить описание световых ореолов, чтобы приблизить результат к исходной эстетике.
✶ вывод
Мне было важно проверить, какие особенности визуального языка могут сохраняться при смене сюжета. Итоговая серия показывает, что модель способна объединять разные пространства и объекты общими оптическими и тональными характеристиками. Но помимо этого в генерациях появляются собственные интерпретации света, фактуры и формы.
✶ применение генеративной модели
— Stable Diffusion XL 1.0 — базовая генеративная модель для создания изображений. С помощью метода DreamBooth LoRA модель была адаптирована к авторскому фотографическому стилю.
Модель: https://huggingface.co/stabilityai/stable-diffusion-xl-base-1.0— BLIP Image Captioning — модель для автоматического создания текстовых описаний исходных фотографий. Полученные подписи использовались при подготовке обучающего датасета.
Модель: https://huggingface.co/Salesforce/blip-image-captioning-base— ChatGPT (OpenAI) — использовался как вспомогательный инструмент при отладке программного кода.
Сервис: https://chatgpt.com/Обучение и генерация выполнялись в Google Colab. Для генерации итоговой серии использовались обученная LoRA, 35 шагов генерации, CFG Scale 5.5 и коэффициент влияния LoRA 0.9.